Un plan de recuperación ante desastres para pymes cabe en una página si responde a cinco preguntas: qué sistemas son críticos, quién decide, en qué orden se recuperan, quién informa y cuándo se probó por última vez. Manténgalo breve, guarde una copia fuera de sus propios sistemas y ensáyelo.
La mayoría de las pymes no necesita un manual. Necesita una hoja que alguien pueda coger una mala mañana, cuando el correo no funciona y la persona que conoce las contraseñas está de viaje. Esta guía explica qué va en esa hoja, quién responde de cada línea y cómo mantenerla al día.
¿Dudas sobre esta guía? Hable con nosotros
Qué contiene un plan de recuperación ante desastres de una página
Un DRP, es decir, un plan de recuperación de desastres informáticos, es un manual de actuación para las primeras horas de un incidente, no un documento de política. Para copias de seguridad, RTO, RPO y la regla 3-2-1, consulte nuestra guía de copias de seguridad y recuperación en lugar de repetirlos aquí. Estos apartados suelen formar parte de una hoja que funciona:
| Apartado de la página | Qué escribir | Quién lo mantiene | Cada cuánto revisarlo |
|---|---|---|---|
| Sistemas críticos | Sistemas que detienen ingresos o servicio, con responsable | Responsable técnico | Cuando cambien los sistemas |
| Roles y suplentes | Tres personas con nombre y un suplente para cada una | Responsable de recuperación | Cuando cambie la plantilla |
| Orden de recuperación | Primero las dependencias, después los niveles | Responsable técnico | Tras cada prueba |
| Contactos y mensajes | Árbol de contactos fuera de línea y quién dice qué | Responsable de comunicación | Cada pocos meses |
| Registro de pruebas | Fecha, resultado y correcciones pendientes | Responsable de recuperación | Tras cada prueba |
Los cinco bloques de la página
La página responde a cinco preguntas. Qué es lo más importante: una lista corta de sistemas críticos, cada uno con su responsable. Quién decide: tres roles con nombre y sus suplentes. En qué orden vuelve cada cosa: una secuencia que respete las dependencias. Quién comunica: un árbol de contactos y los mensajes que oirán la plantilla y los clientes. Cuándo se probó por última vez: una fecha, el resultado y lo que sigue pendiente. Cada bloque ocupa pocas líneas. Si uno necesita un párrafo de explicación, llévelo a un documento enlazado y deje en la página solo una referencia.
Escenarios que conviene planificar primero
Conviene planificar primero los fallos habituales, que son los que un equipo pequeño suele encontrar: un disco que se estropea, un borrado accidental, un portátil perdido o robado, una cuenta comprometida, la caída de un proveedor y un local inaccesible. Una sola página sirve para todos, porque las preguntas se repiten: qué está afectado, quién decide, qué vuelve primero y quién informa a quién. Escriba una línea por escenario indicando qué sistema o persona sufre más. Los sucesos mayores, como un incendio o un corte de luz prolongado, usan la misma hoja; simplemente afectan a más sistemas a la vez.
Una página frente a un plan de continuidad completo
Un plan de continuidad del negocio abarca toda la organización: locales, personas, proveedores, clientes y la forma de seguir trabajando. Su parte informática es el plan de recuperación, y la versión de una página es la hoja a la que se acude primero. El detalle va en documentos enlazados, como contratos de proveedores, esquemas de red y procedimientos de restauración; la página en sí lleva nombres, sistemas, orden y contactos. Si ya dispone de un plan de continuidad, mantenga la hoja informática aparte, para poder imprimirla, guardarla fuera de línea y entregársela a un suplente sin el resto.
Roles, decisiones y árbol de contactos
Tres roles con nombre, una regla sobre quién declara el incidente y un árbol de contactos fuera de línea cubren a la mayoría de los equipos pequeños. Siga este orden:
- Nombre un responsable de recuperación que pueda declarar el incidente y decidir qué se recupera primero.
- Nombre un responsable técnico que ejecute las restauraciones, sea empleado, proveedor externo o ambos.
- Nombre un responsable de comunicación que hable con la plantilla, los clientes y los proveedores.
- Añada un suplente para cada rol y escriba que toda tarea sin dueño recae en el responsable de recuperación.
- Decida quién aprueba gastos de emergencia y anote el límite.
- Monte un árbol de contactos que funcione cuando sus sistemas no lo hagan.
BlueNova IT ofrece de forma habitual IT cogestionada, en la que gestionamos la IT junto al equipo del cliente, así que un proveedor externo puede figurar en el árbol junto a su propio equipo, con su horario de soporte publicado. Anote junto a cada nombre el horario de soporte del proveedor, el nuestro incluido. El alcance se acuerda por organización.
Tres roles que cubren a un equipo pequeño
En un equipo pequeño suelen bastar tres roles. El responsable de recuperación declara el incidente, decide qué ocurre primero y da por terminada la emergencia cuando se reanuda el servicio normal. El responsable técnico ejecuta las restauraciones y lleva un registro de qué se hizo y cuándo. El responsable de comunicación habla con la plantilla, los clientes y los proveedores, y es el único que lo hace. En una empresa muy pequeña una persona puede asumir dos roles, pero anote cuáles, y evite que el responsable técnico sea también el de comunicación: restaurar y explicar a la vez suele salir mal.
Suplentes y quién aprueba los gastos
Nombre un suplente para cada rol. Las personas están de vacaciones, enfermas o ilocalizables justo ese día, y la página debe seguir funcionando. Añada una línea que diga que cualquier tarea sin dueño recae en el responsable de recuperación, para que nada espere a un voluntario. Después decida quién aprueba gastos de emergencia: un portátil de sustitución, la visita urgente de un proveedor o un servicio temporal. Escriba el nombre de la persona y el límite que puede autorizar sin consultar a nadie más. Si el responsable de recuperación es también el propietario del negocio, indíquelo y nombre quién aprueba cuando no se le pueda localizar.
Un árbol de contactos que funcione sin correo
El correo puede ser lo primero en fallar, así que la lista de contactos ante incidentes no puede depender de él. Use números de móvil y direcciones personales, y ponga el rol de cada persona junto a su nombre. Indique quién llama a quién, para que nadie tenga que telefonear a todos. Decida de antemano quién puede hablar con clientes, aseguradora y medios; el resto remite las preguntas al responsable de comunicación. Guarde el árbol fuera de los sistemas que pueden caerse: una copia impresa, una nota en los teléfonos personales o un archivo en un servicio del que su empresa no dependa. Al menos dos personas deben tener una copia actual.
Proveedores, aseguradora y soporte IT externo
Añada los contactos que, de otro modo, tendría que buscar con prisa: su proveedor de internet, los principales proveedores de software y alojamiento, la aseguradora con el número de póliza y el soporte IT externo en el que se apoye. Junto a cada uno, escriba qué le pediría y el horario de soporte que ellos publican, no el que usted supone. Compruebe qué exige la póliza que se comunique y quién lo hace. Un proveedor externo puede figurar como apoyo del responsable técnico o como primera llamada para sistemas concretos; lo que cubre cada proveedor es lo que se pacta con él, así que anote lo realmente acordado, no lo que desearía.
Sistemas críticos y orden de recuperación
El orden de recuperación de sistemas es una lista corta de qué vuelve primero y por qué. Constrúyala en cuatro pasos:
- Liste los sistemas que detienen los ingresos o la atención al cliente si fallan, y nada más.
- Dé a cada sistema un responsable de negocio y otro técnico.
- Agrupe la lista en pocos niveles: necesario primero, necesario después y puede esperar.
- Revise las dependencias de cada sistema y adelante en el orden aquello de lo que dependan.
BlueNova IT puede ayudar a revisar sus sistemas, con servicios de redes e infraestructura y de cloud y Microsoft 365, con un alcance acordado con cada organización. Para fijar los objetivos de recuperación de cada sistema, use la guía de copias de seguridad enlazada antes; la página no debe llevar tiempos ni promesas.
La lista corta de sistemas críticos y sus responsables
Liste solo lo que detiene los ingresos o la atención al cliente. En la mayoría de las pymes eso significa el inicio de sesión, el correo, el sistema de facturación o de pedidos, los archivos compartidos y la conexión a internet; la suya puede añadir una herramienta de reservas, la centralita o un terminal punto de venta (TPV). Junto a cada sistema escriba su responsable y dónde viven sus datos: en un servidor, en un servicio en la nube o en un portátil. Si un sistema no está en la lista, la página no lo cubre, y es deliberado: una lista larga esconde lo poco que importa. Revísela cuando añada o retire un sistema.
Niveles en lugar de una lista larga
Asigne a cada sistema un responsable de negocio y otro técnico. El de negocio decide cuánto daño causa la interrupción y, por tanto, en qué nivel entra; el técnico sabe cómo se restaura. Use tres niveles sin tiempos: necesario primero, necesario después y puede esperar. Los tiempos invitan a promesas que nadie puede cumplir, mientras que una clasificación abre una conversación útil sobre lo que el negocio necesita de verdad. Resuelva los desacuerdos de antemano, con el responsable de recuperación como árbitro, para que nadie discuta prioridades en mitad de un incidente.
Dependencias: primero inicio de sesión, red e internet
Ordene en niveles y recupere después según las dependencias: identidad y red van antes que las aplicaciones que dependen de ellas. Si la plantilla no puede iniciar sesión, o la oficina no llega a internet, un sistema de facturación perfectamente restaurado no sirve de nada. Una cadena típica va de la conexión a internet y la red al inicio de sesión, de ahí a los archivos compartidos y el correo, y por último a las aplicaciones de negocio. Escriba la cadena como una secuencia numerada breve al pie de la página. Si usa Microsoft 365, añada las cuentas de administrador y quién las custodia, porque perder el acceso a ellas frena todo lo demás.
La primera hora: contener, decidir y comunicar
La primera hora de un incidente marca lo ordenado que será el resto. Declare el incidente, abra un registro, contenga antes de restaurar, valore qué está afectado e informe a las personas adecuadas por canales que no dependan de los sistemas caídos. El responsable de recuperación toma la decisión de empezar, y nadie restaura nada hasta entonces.
Contener antes de restaurar: un equipo formateado a toda prisa se lleva consigo las pruebas.
Escriba estos primeros pasos como cinco líneas cortas y en orden, para que un suplente pueda seguirlas sin conocer el contexto. Los servicios de ciberseguridad e IT gestionada de BlueNova IT pueden ayudar con la seguridad de las cuentas. Es preparación previa, no un servicio de respuesta a incidentes ni de monitorización: la página nunca debe dar por hecho que alguien ajeno a su equipo está disponible fuera de su horario de soporte publicado.
Declarar, registrar y contener
Declare el incidente, abra un registro escrito con horas y decisiones y avise al responsable de recuperación antes de que nadie empiece a restaurar. El registro puede ser un cuaderno; lo que importa es que cada acción lleve al lado una hora y un nombre. Después, contenga: frene la propagación, conserve lo que pueda necesitarse para investigar y evite formatear a toda prisa los equipos afectados. Si una cuenta parece comprometida, restablezca sus credenciales y cierre sus sesiones activas; nuestra lista de comprobación de seguridad en Microsoft 365 para pymes recoge los ajustes que ayudan a hacerlo con calma.
Quién se entera de qué y en qué orden
Informe primero a la plantilla, porque es la que recibirá preguntas y necesita saber qué debe dejar de hacer. Después, a los clientes y proveedores realmente afectados, luego a la aseguradora y a nadie más salvo que haya un motivo. Cada mensaje debería decir con palabras sencillas qué ha ocurrido, qué se está haciendo y cuándo llegará la siguiente actualización, sin aventurar causas. Deje escritos en la página los textos breves ya aprobados, de modo que la persona de comunicación solo edite unas líneas en lugar de redactar bajo presión, y designe un único portavoz para mantener un relato coherente.
Canales que funcionan cuando sus sistemas no están disponibles
Si el correo y el chat son precisamente lo que ha fallado, no podrá usarlos para anunciar el problema. Anote los canales alternativos: llamadas desde el árbol de contactos, una aplicación de mensajería en los móviles personales, un SMS a la plantilla y un mensaje grabado en la línea principal. Indique quién envía qué y mantenga los textos cortos y aprobados de antemano. Pruebe también los canales, no solo el plan: compruebe que los números están al día, que todos saben dónde está la copia impresa y que alguien fuera de la oficina puede enviar el primer mensaje si el local no está disponible.
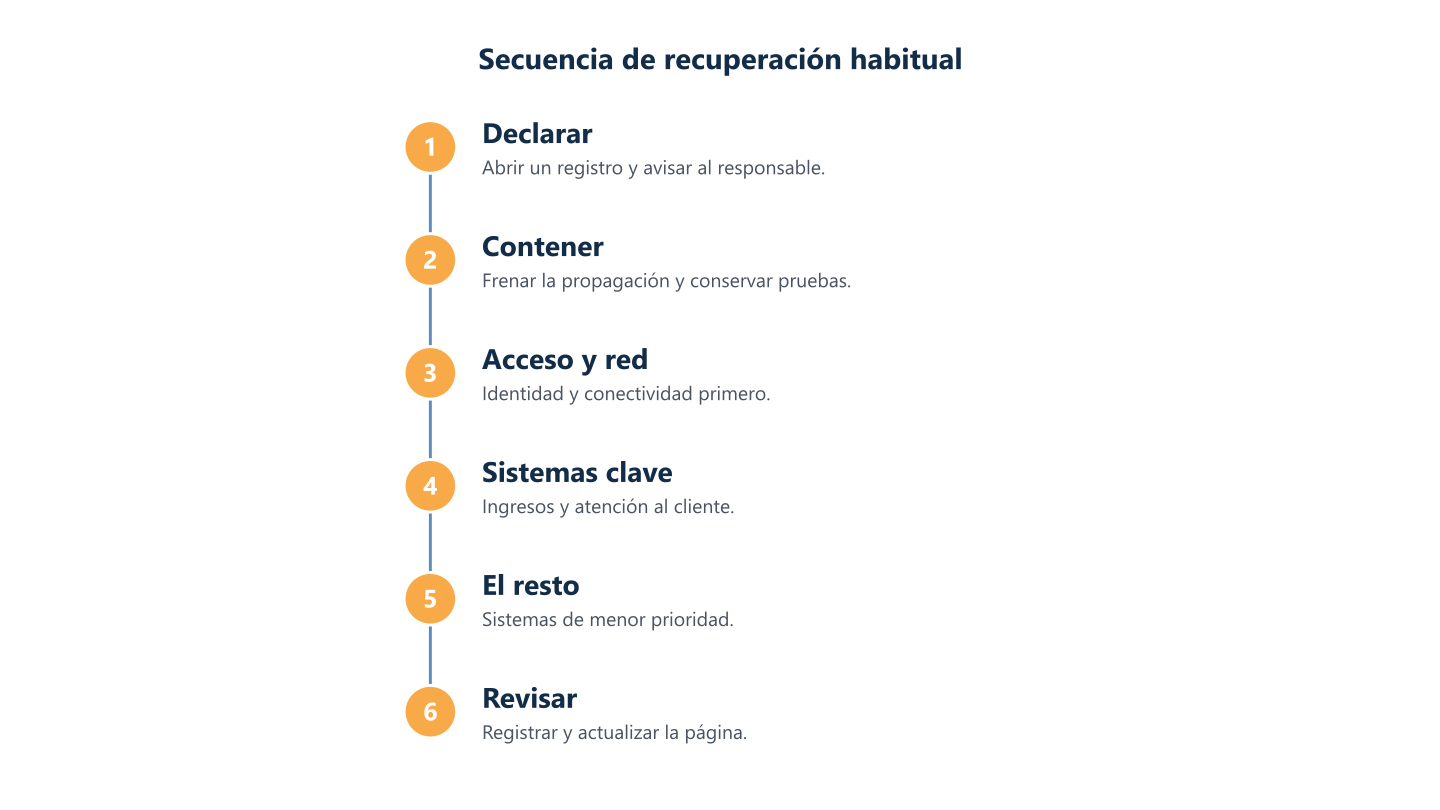
Leer los pasos en texto
Declarar, contener, acceso y red, sistemas clave, el resto, revisar
Probar el plan y mantenerlo al día
Un plan de recuperación ante desastres para pymes que nunca se ha ensayado es un conjunto de suposiciones, y el primer ensayo suele destapar los huecos. Haga dos tipos de prueba: un repaso breve con las personas nombradas en la página y una restauración real de un sistema. Revise la página cuando cambien los sistemas, los proveedores o las personas, ponga fecha a cada versión y guarde copias fuera de los sistemas que puedan caerse. Tras un incidente real, anote lo ocurrido y actualice la página mientras todo está fresco. Los servicios de IT gestionada de BlueNova IT pueden ayudar a planificar estas pruebas, y el primer paso es ponerse en contacto con nosotros para hablar de sus necesidades. Los resultados dependen de sus sistemas, de sus datos y del incidente.
Un repaso con las personas que figuran en la página
Repase un escenario realista con las personas nombradas en una sola sesión corta. Elija algo corriente, como que los archivos compartidos no estén disponibles un lunes por la mañana mientras el responsable de recuperación está de baja. Pregunte a cada persona qué haría primero y lea la página en voz alta sobre la marcha. Anote cada pregunta que la página no sepa responder: un número que falta, un responsable poco claro, un sistema que nadie incluyó. Corrija esos huecos antes de terminar o asigne cada uno a una persona con nombre. El objetivo no es un ejercicio perfecto, sino una página que responda a todo lo que surja.
Probar una restauración real
Restaure un sistema real en un entorno aparte y compare el resultado con lo que supone el plan. Elija un sistema del primer nivel, a ser posible uno cuyo responsable pueda confirmar que los datos están completos y son utilizables, no solo que están. Anote cuánto ha tardado, para alimentar los objetivos de recuperación de la guía de copias de seguridad, y también qué faltaba y qué paso dependía de lo que sabe una sola persona. La próxima vez repita con otro sistema, de modo que, tras unas cuantas pruebas, toda la lista haya sido ejercitada.
Cuándo revisarlo y dónde guardar las copias
Revise la página tras cualquier cambio de sistemas, proveedores o personas, y al menos una vez al año; ponga fecha a cada versión para que nadie trabaje con una antigua. Conserve una copia impresa en la sede principal y con cada responsable y su suplente, además de un archivo actualizado en un lugar que no dependa de su propia red. Retire las copias obsoletas cuando emita una nueva. Incluya también la fecha de revisión en su planificación general: la hoja de ruta de transformación digital para pymes ayuda a ordenar un año de trabajo de IT, y esta página merece figurar en esa lista.
Tras un incidente: registrar y actualizar
Use el registro que llevó para redactar una revisión breve mientras los recuerdos están frescos: qué ocurrió, qué funcionó, qué no y qué va a cambiar. Manténgala objetiva y evite señalar culpables, porque quien teme el reproche deja de anotar lo que hizo. Convierta cada hallazgo en una edición de la página o en una tarea con responsable, actualice la fecha y vuelva a emitir las copias. Si el incidente reveló un sistema que nadie había listado, añádalo a los niveles. Comparta la página revisada con todos los nombrados en ella, para que la siguiente persona que la coja parta de lo aprendido. Guárdela con el resto de sus registros: vea documentación de IT: qué conservar y dónde.
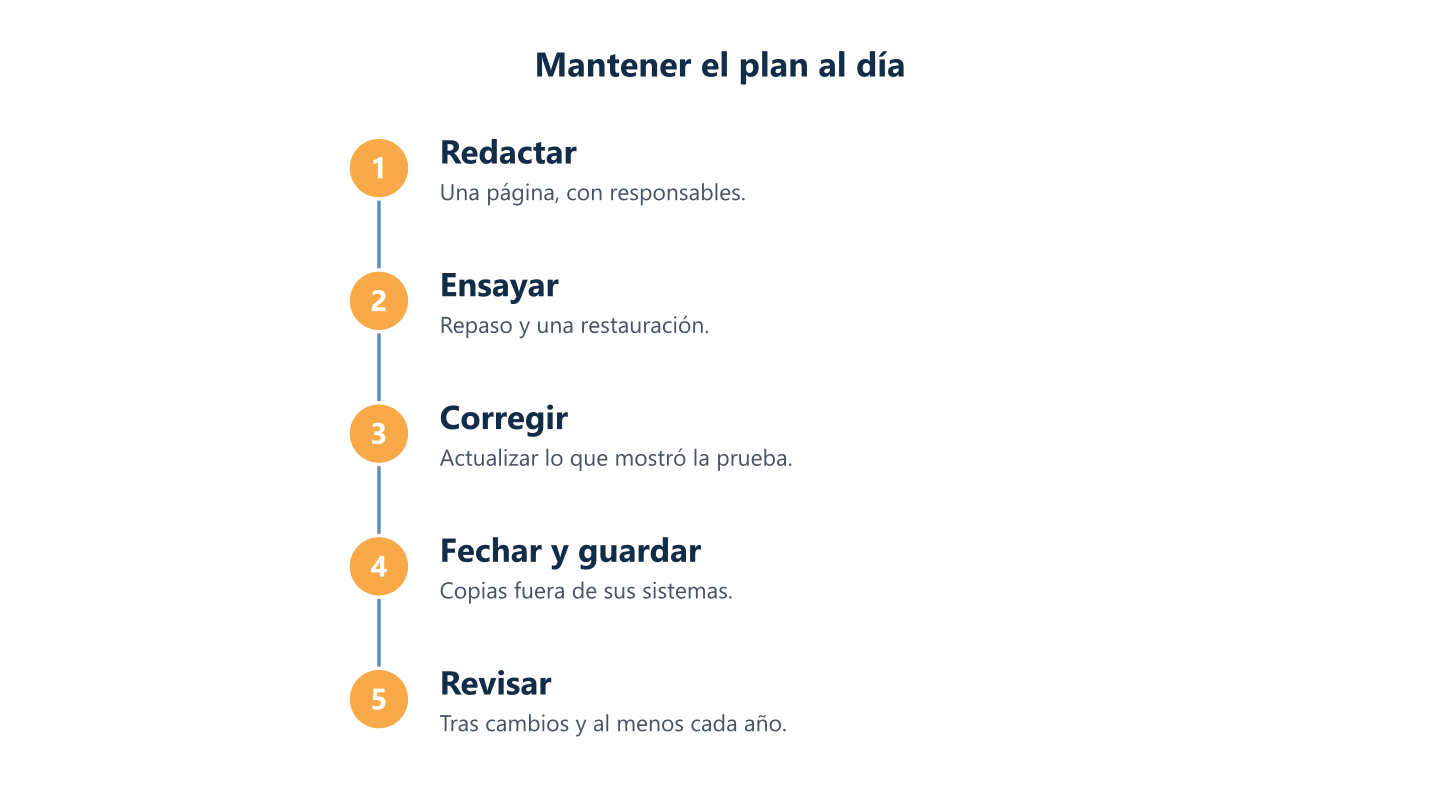
Leer los pasos en texto
Redactar, ensayar, corregir, fechar y guardar, y revisar
Un plan vale lo que valga su último ensayo. Elija un sistema, un escenario y una tarde de este mes, y corrija lo que la prueba revele. Mantenga la página corta, guarde una copia fuera de sus propios sistemas y deje que cada ensayo le indique qué cambiar después. Para la parte de los datos, vuelva a la guía de copias de seguridad que aparece antes en este artículo. Si desea comentar su propia configuración, atendemos en inglés y español, de lunes a viernes, de 09:00 a 18:00 CET.